
最近更新
新发布和修订的文章、Skill 与工具,按时间整理在这里。
豆包视频去水印
拖入豆包视频,自动识别并修补角落水印,预览后下载。不裁切画面。
南鸢 Codex 工作站
在 Codex 桌面里查看项目与任务、并排打开最多四个对话,随手调用 Skills 和本地素材。附源码安装与上手指南。
把游戏设计里的631 原理,转化成可以复用的提示词结构
用原理动图、三组 AI 对照与五部电影的资料图,讲清 631 如何组织配色、光照、形体和细节,并把影视置景拆成空间底盘、人物生活和剧情重点,给出可替换的提示词结构。
AI 视频怎么运镜?把这 17 个摄影机运动讲明白(附示例)
沿知识站镜头语言库的17项摄影机运动,用可见画面和中文短句讲清推拉、摇摄、跟拍、环绕及组合运镜,帮助读者把镜头想法写清楚。
服装提取与资产板生成
从穿搭参考提取整套造型与独立拆件,生成可复用的服装资产板。
我给 AI 视频角色造了一间衣帽间:服装提取 Skill
介绍服装提取 Skill 如何把网络穿搭参考图变成整套与拆件资产板,以及它在 AI 视频角色服装设计和镜头对照中的用途。
我把摄影里的布光,写成了 AI 能用的短提示词模板
用同一人物参考的并列生成图,讲清六种常用光、三种创意光怎么写成可检查的短提示词,并说明未命中的边界。
如何玩转参考图?我总结出了这句短提示词!!
用17个维度的真实对照图和一条短提示词,分享从调色迁移试错到视觉感觉重绘的方法、连带变化与组合用法。
视觉词库
搜索视觉词、浏览组合配方,或随机抽一组画面灵感。公开体验,完整词库需会员。
视频转深度
在浏览器本机将短视频逐帧转换为近白远黑的相对深度图,保留视频节奏,下载静音 MP4。建议使用支持 WebGPU 的桌面 Chrome / Edge。
测试了四五百张图,我终于找到一种好写的 AI 表情提示词
从眉眼嘴的局部控制,到事件驱动和内外情绪关系,用实际生成案例讲清 AI 角色表情怎么写,并提供可直接替换的提示词模板。
角色资产拼图
上传角色肖像与全身图,自动分类排版;支持圆形去头、图层锁定、拖动标注、项目保存与 PNG 导出。
把摄影里的机位讲明白,写 AI 人像提示词就有思路了
把人像机位拆成高度、方位与距离,结合镜头朝向和景别,讲清平视、焦距与情绪表达中的常见误区。
我把摄影里的美姿经验,写成了 AI 能用的短提示词
把人像美姿经验压成转、弯、顺、露四个短公式,用具体朝向、动作与手位编写AI人像提示词。
南鸢视频下载器
在自己电脑上批量解析并下载视频,结果可整理为 ZIP。
《我的妹妹不可爱》拉片拆解学习
从罗臣臣《我的妹妹不可爱》上部的三个具体片段出发,分享拉片笔记,以及重新获得自己剧本设定灵感的经历。
视觉方向小样校准
批量生成前先锁定审美目标,用少量有区分度的小样比较差异,再确定后续保留的视觉锚点。
把方法做成 Skill
判断重复任务是否值得封装,再设计、创建、审计和验证最小可用 Skill。
小红书长文图文排版
把长文重组为连贯的 3:4 滑动阅读图文,交付可编辑 HTML 与批量 PNG。
GPT Image 创作路由
从用途出发选择合适的图像模板,把松散需求整理为完整提示词与生图任务。
中文概念海报
把一个中文词或短句转成文字与视觉隐喻共同构成的独立海报。
我发现一个宝藏博主,他把 GPT-image-2 的审美开关写明白了
通过小小东的词义海报与真实试作,理解材质、工艺和视觉矛盾如何替代空泛的高级感。
你买了 ChatGPT,却可能一直没打开真正能干活的 Codex
记录从官方入口安装、登录和确认工作区可用的过程,帮助第一次接触 Codex 的读者建立起点。
Codex 保姆级入门教程:最近更新这么猛,普通人也该认真试一次了
从练习文件夹和只读任务开始,跑通文章配图任务,理解 Codex 的权限、验证与交付。
AI 生图总把「中式审美」画成古代,我们的现代审美去哪了?
从中式符号的模板化现象出发,把材质、构图与当代生活转成更具体的视觉语言。
零基础也能用 AI 做产品?一条路从想法到上线
把产品想法推进到原型、规范、实现和回读,帮助非技术创作者理解真实交付需要哪些步骤。
豆包开始收费了:免费的,迟早会变成不好用的
2026 年 5 月的工具付费观察,讨论免费服务依赖、替代方案与工作流成本,不作为当前价格指南。
手把手教你把任意图片,做成专属 Codex 桌面宠物(官方正规流程)
从真实桌面宠物的失败到可运行图集,讲清动作状态、透明背景、拆分、验证与打包。
我让 Codex 整理个人知识库,它反过来给了我 6 条工作建议
六条可直接使用的工作指令,覆盖任务约定、关键节点、真实验收、经验沉淀和工具迁移。
我烧了上千积分,拿即梦 Seedream 5.0 Pro 对打 Image 2.0,结果有点尴尬
保留 Seedream 5.0 Pro 与 Image 2.0 的九组历史题材对照,观察表情、文字、指令遵循与成像差异。
我妈让我判断一张图真假,我第一次不敢打包票
从真假图片测试出发,讨论为什么视觉瑕疵越来越不可靠,以及普通人怎样追查来源和核对事实。
已经有一套 AI 生图课了,我为什么又重写了 7 万多字?
从旧课重写到六篇入门和十五篇主线,解释课程为什么从观察画面、控制变量和真实失败开始。
小红书个人形象分析,我用AI逆向跑出来了
把个人形象分析卡拆成元结构与主题变量,用同一个版式迁移人像、妆容、色彩和发型主题。
一切皆插件,但普通人真的用得上 DeepSeek Harness 吗?
一次 DeepSeek Harness 的实际体验:插件架构带来什么自由,又给普通使用者增加了哪些门槛。
PR、CI、Commit 到底是什么?Vibe Coding 新手第一份术语表
沿着修改、保存、检查与发布的顺序,理解 Repo、Commit、PR、CI 和线上回读。
GPT-image-2:从"写提示词"到"给提示",普通人的分水岭来了
记录从七要素模板转向画面意图的创作转变,比较感觉描述、参考图与逐轮沟通的作用。
GPT-image-2 不是怕提示词长,是怕你给它太多方向
通过人像提示词减法实验,分清描述长度与方向冲突,保留真正决定画面的视觉关系。
Codex完整入门教程 01,我是怎么从零开始理解 Codex 的
用真实写作工作区解释 Codex 怎样读规则、处理文件,以及新手如何开始第一个小任务。
AI 做 Logo 总觉得廉价?一套提示词结构,跑通 7 个行业的品牌提案
把 Logo 方向、品牌气质与应用触点拆开,用七个真实案例解释品牌展示板的提示词结构。
GPT Image 2.5 人像对比:看完这七组,我更想念旧版了
用七组人像结果对比新旧生图体验,记录面部、肤质、光影与风格变化,并说明这次审美判断的测试边界。
拆完《万物生》的创作画布,我总结了几个作者的创作理念
从《万物生:问心》的公开创作画布提炼先建立拍摄系统、再组织镜头事件的视频提示词方法。
MJ V8 提示词怎么写?别再堆相机参数了
把 Midjourney 摄影提示词拆成主体、观看方式、镜头感觉、光线、质感和参数,帮助新手定位需要修改的画面变量。
MJ 人像磨皮感太重?这段 Prompt 能把真实纹理补回来
用一段可复制的 Midjourney 人像提示词补充真实肤质,并通过配图辨别纹理与磨皮感的变化。
写真skill升级,增加了下面几个新功能(开源版)
介绍写真 Prompt Skill v1.1.0 的身份与方案分控、摄影企划复拍和逐张检查,并提供完整开源版入口。
做前端 Vibe Coding,先看懂这 12 个网页基础术语
用十二个网页基础术语,帮助 Vibe Coding 新手准确描述页面结构、样式、布局和交互需求。
同一组短词,我只删了标签,AI 生图方向就变了
对照同一组短词有无模块标签的生成结果,观察标签怎样影响模型组织画面。
GPT 出图总是漂亮但没灵魂?这套表情词典,让人物真正活起来
用表情词汇和真实图片示例,把人像的情绪、目光、嘴部与身体反应拆成可以表达的视觉线索。
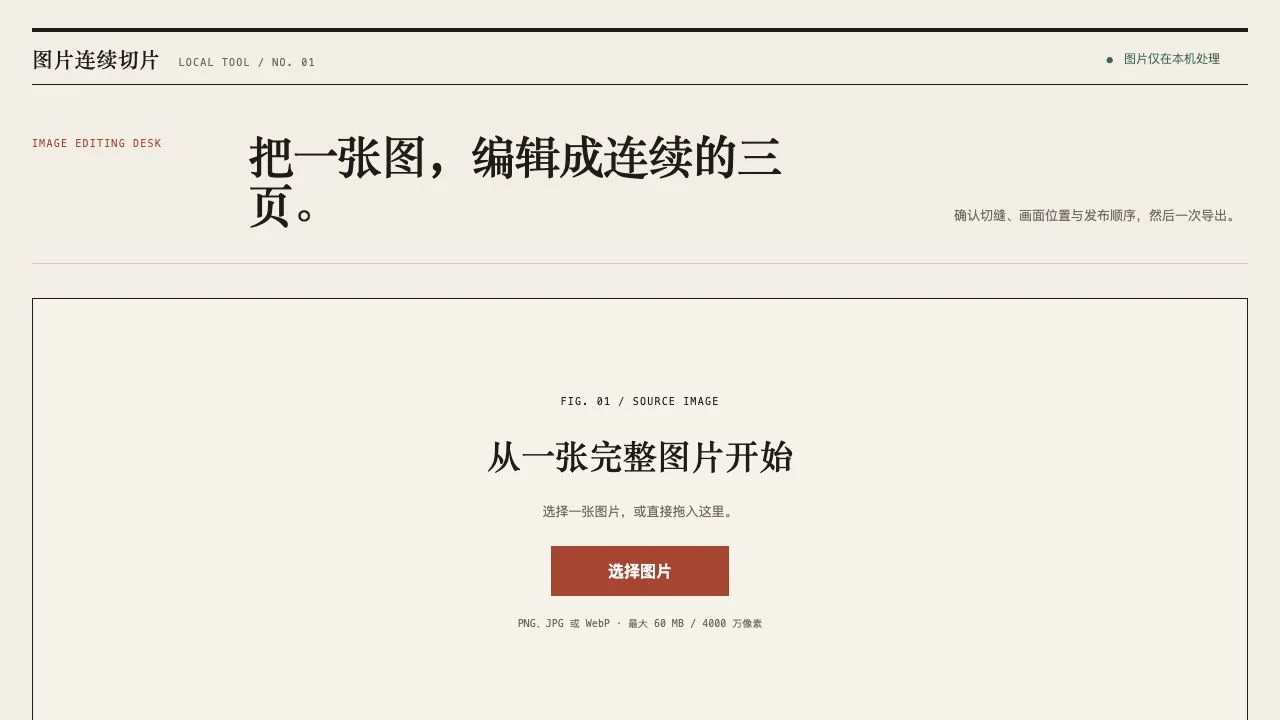
图片连续切片
在浏览器本地把一张图片切成连续的多张图片,支持左右轮播与上下切片。
南鸢写真提示词
把人物身份与写真方案分开控制,按同一摄影企划复拍新分镜,并逐张检查光线、空间与系列一致性。
一段 Prompt,生成 3 套杂志感文章封面
分享一段可直接复制的文章封面 Prompt:根据标题与可选摘要理解文章主题,并生成 3 套明显不同的 16:9 杂志感封面方案。
拆开 DeepSeek Harness,从 0 到 1 先看懂 Agent
从 DeepSeek Harness 的第 0 章出发,用普通人能理解的方式讲清 Agent、记忆、Token、工具调用、依赖和状态机。
从一句想法到完整成片,我一个人跑通了 AI 视频全流程
用两个真实短片拆解从想法、剧本、分镜、出图、视频生成到基础剪辑的完整 AI 视频流程,并记录失败补图与工具边界。
FDE 火了,但懂业务的人更该看看 AIBP
从真实招聘与业务流程出发,拆解 FDE 和 AIBP 的职责差异,并给出把 Agent 放进业务、保留人工确认与效果评估的 12 周实践路径。
Grok 这次中文排版杀疯了,但我测完还是想泼一盆冷水
用海报、信息图和写真人像等真实对照,比较新版 Grok 与 GPT Image 2 在中文排版、审美组织和长提示词执行上的差异。
构图是语法,故事是语义:AI生图的双层视觉导演法(下)
学会如何去描述一个带场景的画面
构图是语法,故事是语义:AI生图的双层视觉导演法(上)
把构图与故事拆成画面语法与语义,解释为什么很多 AI 图片第一眼好看、第二眼却留不下内容。
为什么你加了「真实皮肤」,脸还是塑料感?
不是毛孔不够多,而是纹理、高光、质感与光线被模型绑在了一起;把皮肤拆成 5 个变量,才能压住油膜与蜡像感。
AI 漫画太像模板?我做了一个先造 IP、再画故事的开源 Skill
从稚拙手绘画风拆解开始,实测三个不同 IP 的身份锁定与双格漫画生成,并公开可复用的白色软块漫画 Skill。
白色软块双格漫画
先建立并确认你自己的白色软块角色,再把一句话、长文或故事转成上下双格的荒诞反差漫画。
Prompt 越存越乱?我用 Codex 做了一个自己的生图词库插件
从网页右键收录到原子词、组合配方和插件回读,用一个最小 Chrome 插件跑通生图 Prompt 词库的完整闭环。
我做了一个专门反推人像的 Skill,但它不负责 1:1 复刻
把人像参考图拆成构图、视线、动作、光线与质感关系,并说明图片反推 Skill 为什么不承诺 1:1 复刻。
生图越多越乱?我用 7 个文件夹,搭了一套 AI 能接手的知识库
用 7 个职责目录、图片与 Prompt 双向追溯和失败记录闭环,搭建一套 AI Agent 能持续维护的生图知识库。
换到 GPT-image-2 后,我建议你先忘掉 Nano Banana 的提示词
通过三组长短 Prompt 对照,解释 GPT-image-2 为什么更需要清楚的风格、画面与必要约束,而不是信息堆叠。
南鸢图片反推
把参考图拆解为画面结构、主体关系、成像系统、参考色卡和可直接生成的完整中文 Prompt。
跑了上千张写真图片后,我总结了一套方法论
从上千张 AI 写真测试中提炼场景、成像、妆容、动作与随机变量的五层 Prompt 方法。